DOM-trädet
Förra veckan såg du att webbläsaren gör om HTML-koden till ett träd av objekt, DOM. Den här veckan börjar du arbeta mot det trädet från din egen kod. Det är egentligen allt det handlar om i webbläsaren: att läsa och ändra dokumentet medan sidan visas. Den här artikeln går igenom vad trädet består av, hur du hittar det du letar efter och hur du rör dig mellan noderna. Hur du ändrar i trädet är ämnet för nästa artikel.
Tidsåtgång: Ungefär 15 minuter.
Några korta frågor finns insprängda i texten. Försök svara innan du klickar fram lösningen.
Ett API mot renderingsmotorn
Section titled “Ett API mot renderingsmotorn”DOM står för Document Object Model. Det är ett API, ett programmeringsgränssnitt, som renderingsmotorn exponerar för JavaScript-motorn. JavaScript har ingen egen kunskap om HTML; varje gång din kod läser eller ändrar något på sidan går det via DOM-API:et. Det är ett av webbens äldsta API:er, och fortfarande det viktigaste.
Ingången är objektet document. Allt arbete mot DOM:en börjar med document. något:
console.log(document.title) // the page's titleconsole.log(document.body) // the body elementconst main = document.querySelector('main')Varje del av dokumentet representeras av ett objekt. Ett <p>-element blir ett
HTMLParagraphElement, som ärver från HTMLElement, Element, Node och EventTarget. Det är
därför alla element har en gemensam uppsättning egenskaper och metoder, som du lär dig i den här
och nästa artikel.
Noder och element
Section titled “Noder och element”Trädet består av noder. Element är den viktigaste sortens nod, men inte den enda. Texten mellan taggarna är egna textnoder, kommentarer är kommentarsnoder och dokumentet självt är en dokumentnod högst upp i trädet.
| Nodtyp | Exempel | nodeType |
nodeName |
|---|---|---|---|
| Element | <h1> |
1 (Node.ELEMENT_NODE) |
'H1' |
| Text | texten i <h1> |
3 (Node.TEXT_NODE) |
'#text' |
| Kommentar | <!-- ... --> |
8 (Node.COMMENT_NODE) |
'#comment' |
| Dokument | document |
9 (Node.DOCUMENT_NODE) |
'#document' |
Alla element är noder, men alla noder är inte element. Den skillnaden kommer att dyka upp hela tiden, eftersom många egenskaper och metoder finns i två varianter: en för noder och en för element.
Mellanrummen räknas
Section titled “Mellanrummen räknas”Enligt standarden blir även mellanrummen i HTML-koden textnoder: radbrytningar och indentering som du skriver för att koden ska bli läsbar. Ta det här lilla dokumentet:
<article> <h1>Buggar</h1> <!-- To do --> <p>Inga kända buggar.</p></article>Trädet för <article> ser ut så här. Element är blå, text grön, kommentaren beige och de streckade
noderna är textnoder som bara innehåller radbrytningar (⏎) och mellanslag (␣):
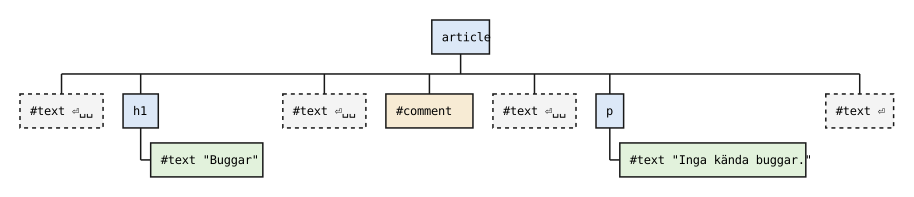
Fyra av sju barnnoder till <article> finns alltså bara för att koden är indenterad. Webbläsaren
visar dem inte, men de finns i trädet och påverkar vad en del egenskaper returnerar, som du snart
ska se.
Fråga: hur många barn?
Section titled “Fråga: hur många barn?”<ul> <li>Ett</li> <li>Två</li></ul>Vad blir ul.childNodes.length och ul.children.length? (childNodes ger alla barnnoder,
children bara barn som är element.)
childNodes.length är 5 och children.length är 2.
childNodes innehåller textnoden med radbrytning och indentering före första <li>, <li>Ett</li>,
textnoden mellan de två <li>-elementen, <li>Två</li> och textnoden före </ul>. children
innehåller bara de två <li>-elementen.
Att välja ut element
Section titled “Att välja ut element”Innan du kan göra något med ett element måste du ha en referens till det. Det enklaste och mest flexibla sättet är Selectors API, två metoder som tar en CSS-selektor som argument:
| Metod | Returnerar |
|---|---|
querySelector(selektor) |
det första element som matchar, eller null |
querySelectorAll(selektor) |
en NodeList med alla element som matchar (kan vara tom) |
const container = document.querySelector('#container')const posts = document.querySelectorAll('.post')const firstHeading = document.querySelector('article h1')const missingAlt = document.querySelectorAll('img:not([alt])')Du använder exakt samma selektorer som i CSS, så allt du kan om CSS-selektorer går att använda
direkt. Det sista exemplet hittar alla bilder som saknar alt-attribut, med en enda rad.
Två saker är bra att veta:
querySelectorreturnerarnullnär inget matchar. Felstavar du selektorn får du inget fel på den raden, utan först när du försöker använda resultatet:TypeError: Cannot read properties of null. Ser du det felet, kontrollera selektorn först.- Metoderna finns även på element.
container.querySelector('p')letar bara blandcontainers ättlingar, inte i hela dokumentet. Det blir viktigt när du bygger komponenter, där varje komponent ska leta i sitt eget innehåll.
De äldre metoderna
Section titled “De äldre metoderna”Innan Selectors API fanns valde man element med metoder som getElementById('container'),
getElementsByTagName('p') och getElementsByClassName('post'). De fungerar fortfarande, och du
kommer att se getElementById i otaliga exempel på nätet, så känn igen dem. I din egen kod räcker
det med querySelector och querySelectorAll. Selektorsyntaxen populariserades av biblioteket
jQuery, och när den blev standard försvann en av de stora anledningarna att använda jQuery.
Ett id ska vara unikt i dokumentet. Finns flera element med samma id returnerar både
getElementById och querySelector('#...') det första, och resten går inte att nå på det sättet.
Samlingar är inte arrayer
Section titled “Samlingar är inte arrayer”Metoderna som returnerar flera noder ger dig en samling, antingen en NodeList eller en
HTMLCollection. Båda har length och går att indexera med [0], men ingen av dem är en array.
NodeList |
HTMLCollection |
|
|---|---|---|
| Kommer från | querySelectorAll, childNodes |
children, getElementsBy... |
| Innehåller | noder (från querySelectorAll bara element) |
bara element |
forEach |
finns | finns inte |
for...of |
fungerar | fungerar |
| Uppdateras när DOM:en ändras | nej från querySelectorAll, ja från childNodes |
ja |
Behöver du map, filter eller någon annan array-metod gör du om samlingen till en array:
const titles = Array.from(document.querySelectorAll('h2'))  .map((heading) => heading.textContent)
// The same thing with the spread syntaxconst sameTitles = [...document.querySelectorAll('h2')].map((heading) => heading.textContent)
Levande och statiska samlingar
Section titled “Levande och statiska samlingar”En levande (live) samling uppdateras automatiskt när DOM:en ändras. En statisk samling är en ögonblicksbild av hur DOM:en såg ut när du hämtade den. Det låter som en detalj, men det kan ge överraskande buggar.
Fråga: hur många blir kvar?
Section titled “Fråga: hur många blir kvar?”En lista innehåller fyra <li class="todo">. Du vill ta bort klassen från alla:
const items = document.getElementsByClassName('todo')
for (const item of items) {  item.classList.remove('todo')}
Hur många <li> har klassen todo kvar efteråt?
Två av fyra har kvar klassen.
getElementsByClassName returnerar en levande HTMLCollection, som bara innehåller element som
just nu har klassen todo. När loopen tar bort klassen från det första elementet försvinner det
ur samlingen, och alla andra element flyttar ett steg fram. Loopen går vidare till index 1, som nu är
det element som från början låg på index 2. Varannan <li> hoppas alltså över.
Med document.querySelectorAll('.todo') får du en statisk NodeList som inte ändras under
loopen, och då får alla fyra klassen borttagen. Det är ett bra skäl att hålla sig till
querySelectorAll.
Att röra sig i trädet
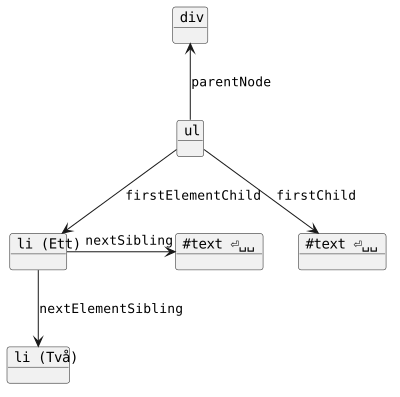
Section titled “Att röra sig i trädet”Ibland har du redan en referens och vill nå något i närheten: elementets förälder, första barn eller nästa syskon. Det kallas att traversera trädet. Egenskaperna finns i två varianter, och det är här mellanrummen gör skillnad:
| Alla noder | Bara element |
|---|---|
childNodes |
children |
firstChild, lastChild |
firstElementChild, lastElementChild |
previousSibling, nextSibling |
previousElementSibling, nextElementSibling |
parentNode |
parentElement |
Nästan alltid är det elementvarianten du vill ha. firstChild i exemplet ovan är textnoden med
radbrytningen, inte det första <li>-elementet. Uppåt i trädet spelar det mindre roll, eftersom
bara element, dokument och dokumentfragment kan ha barn. parentNode och parentElement ger
samma resultat utom högst upp, där <html>-elementets parentNode är document och dess
parentElement är null.
Ett mer flexibelt sätt att gå uppåt är closest(), som letar efter den närmaste förfadern (eller
elementet självt) som matchar en selektor:
const article = heading.closest('article')Den kommer du att ha stor nytta av i kursvecka 11, när du hanterar händelser.
Behöver du inte röra dig relativt ett visst element är querySelector ofta enklare. Vill du ha
den första rubriken i varje artikel skriver du querySelectorAll('article > h1:first-of-type')
i stället för att gå igenom varje artikel och traversera.
Se DOM:en i utvecklarverktygen
Section titled “Se DOM:en i utvecklarverktygen”Fliken Elements (Inspector i Firefox) i utvecklarverktygen visar DOM-trädet som det ser ut just nu, med alla ändringar din kod har gjort. Visa sidkällan (View page source) visar i stället HTML-koden som servern skickade, innan någon JavaScript körts. När du arbetar med DOM:en är det nästan alltid Elements du vill titta i; sidkällan visar inte ett enda element som din kod har lagt till.
Två knep som sparar tid:
- Markera ett element i Elements och skriv
$0i konsolen. Då får du en referens till elementet och kan prova egenskaper och metoder direkt, till exempel$0.childreneller$0.closest('div'). - Skriv
document.querySelectorAll('...')i konsolen för att testa en selektor innan du använder den i koden.
Fråga: vilken nod?
Section titled “Fråga: vilken nod?”Ta listan från den första frågan igen, och anta att ul är en referens till <ul>-elementet:
<ul> <li>Ett</li> <li>Två</li></ul>Vad ger de här tre uttrycken?
ul.firstChild.nodeNameul.firstElementChild.nodeNameul.firstElementChild.nextSibling.nextSibling.textContent'#text'. Det första barnet är textnoden med radbrytningen och indenteringen före första<li>.'LI'.nodeNamereturnerar elementnamn med versaler i HTML-dokument.'Två'. Från första<li>ledernextSiblingtill textnoden mellan elementen, och nästanextSiblingtill andra<li>. MednextElementSiblinghade ett steg räckt.
Vill du prova själv: klistra in listan i en index.html, markera <ul> i Elements och byt ut ul
mot $0 i konsolen.
Att ta med sig
Section titled “Att ta med sig”- DOM är webbläsarens API mot dokumentet, och
documentär ingången. - Alla element är noder, men alla noder är inte element. Även mellanrum blir textnoder.
- Välj element med
querySelectorochquerySelectorAll. Räkna med attquerySelectorkan genull. - Samlingar är inte arrayer. Använd
Array.from()när du behöver array-metoder, och se upp med levande samlingar. - När du traverserar vill du nästan alltid ha elementvarianterna:
children,firstElementChild,nextElementSibling. - Titta på DOM:en i Elements, inte i sidkällan.
Vidare läsning
Section titled “Vidare läsning”- Läsanvisningarna för veckan, i synnerhet kapitel 15.3 i kursboken.
- Introduction to the DOM på MDN.
- Locating DOM elements using selectors på MDN.
- Fortsätt med nästa artikel, Att ändra i DOM:en.

